Lors de mon intervention au VLC2015, j’ai montré un exemple de site WP par défaut, puis après optimisation de son maillage interne.
Voici un peu plus en détail les différences.
Le Site en question est un WordPress que j’ai laissé au début totalement par défaut, sans aucune opti.
J’ai créé 3 catégories, et une dizaine d’articles par catégorie.
Pour 2 catégories, j’ai mis plus de 10 articles pour avoir une pagination (soyons vicieux!)
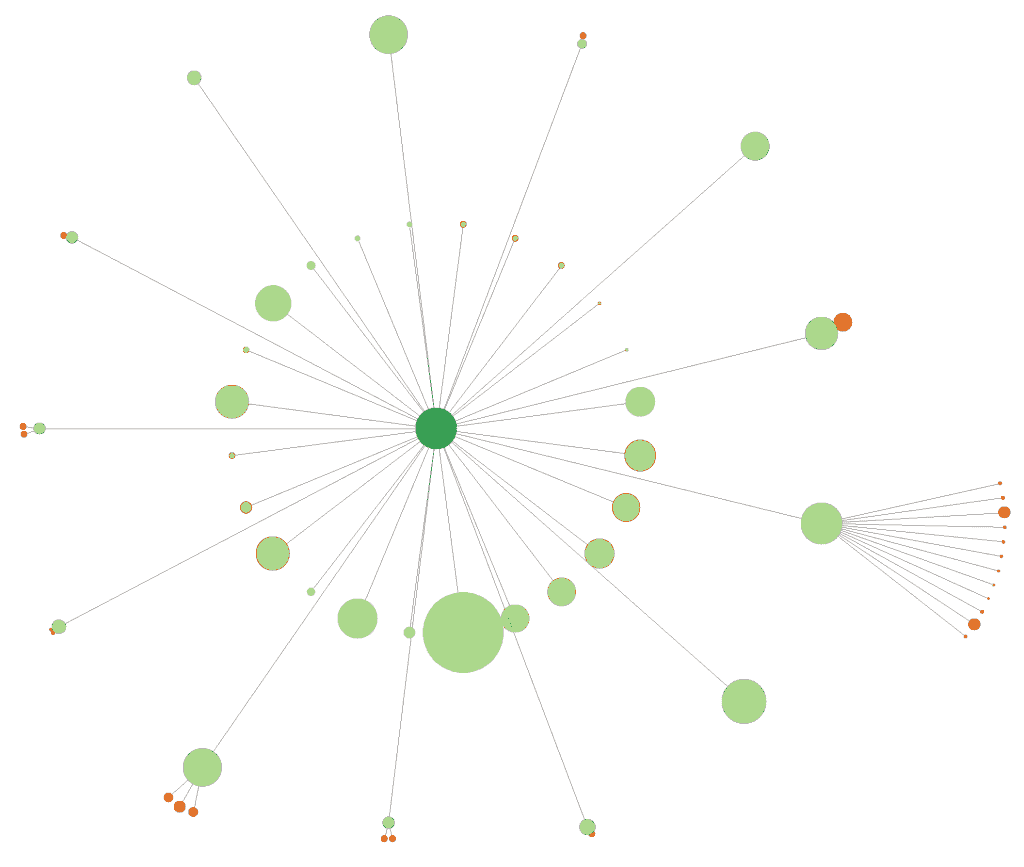
Voici ce que donne la vue « crawler » pour ce premier jet
NB: Cf ici pour la description de la visualisation utilisée
Quelques constatations rapides :
- Quasiment toutes les pages sont liées depuis la page d’accueil
- Une page a un PR plus important que la page d’accueil
- On ne devine pas qu’il y a 3 catégories différentes
Aucune structure ne se détache, il n’y a qu’un tas de liens et de pages.
Et si on ré-organise ?
Bien sur, vous allez me dire que Google reconnait les WordPress, et qu’il est assez fort pour recoller les morceaux. Peut être, et moi aussi…
Après avoir ré-organisé les pages selon leur hiérarchie supposée (les articles sous la catégorie, les tags sous les articles), voilà ce qu’on obtient :
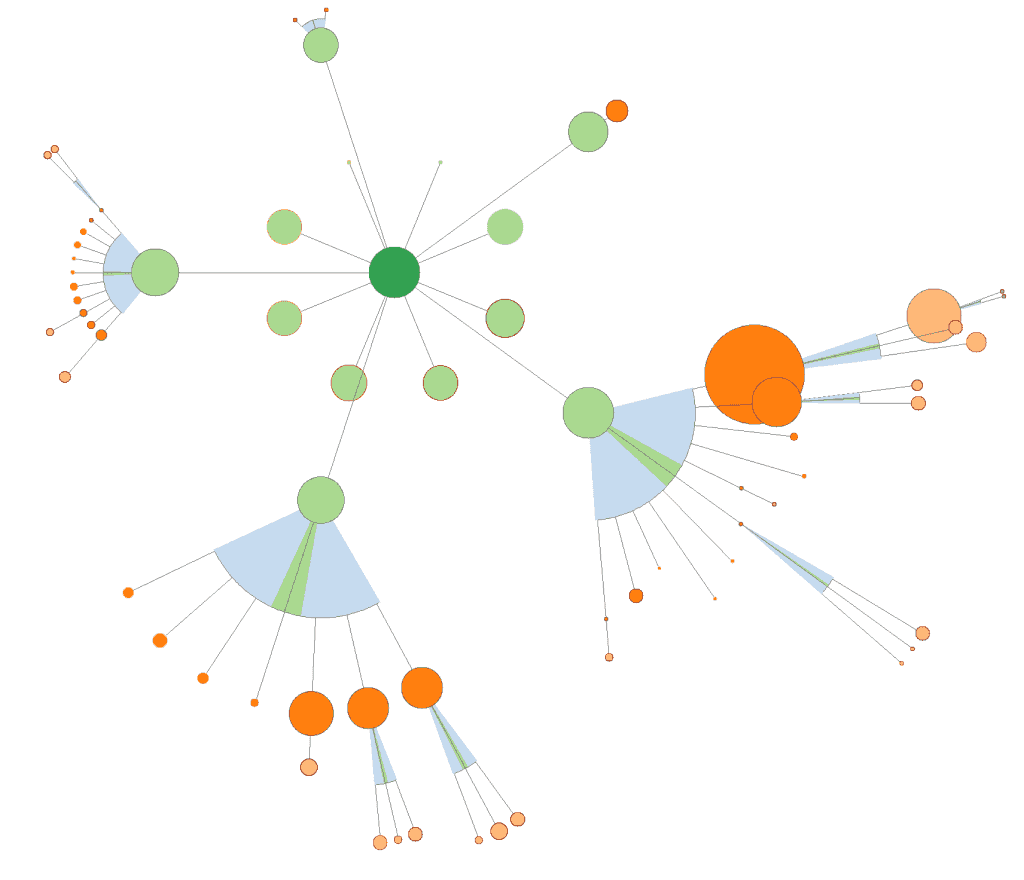
Ici, on a « triché »: ce n’est plus une vue crawler, mais une vue « Url hiérarchique ».
Ceci dit, ça ne change rien au problème : on a toujours une page (un article) qui aspire l’essentiel du jus du site, des répartitions de jus très disparates, et des silos qui sont très mal isolés (très peu de vert dans les éventails).
Faire mieux avec un WordPress ?
Et bien oui, on peut.
Même sans plugin, même en utilisant des articles et pas des pages !
Voici ce à quoi on arrive après quelques optimisations de base, du même site :
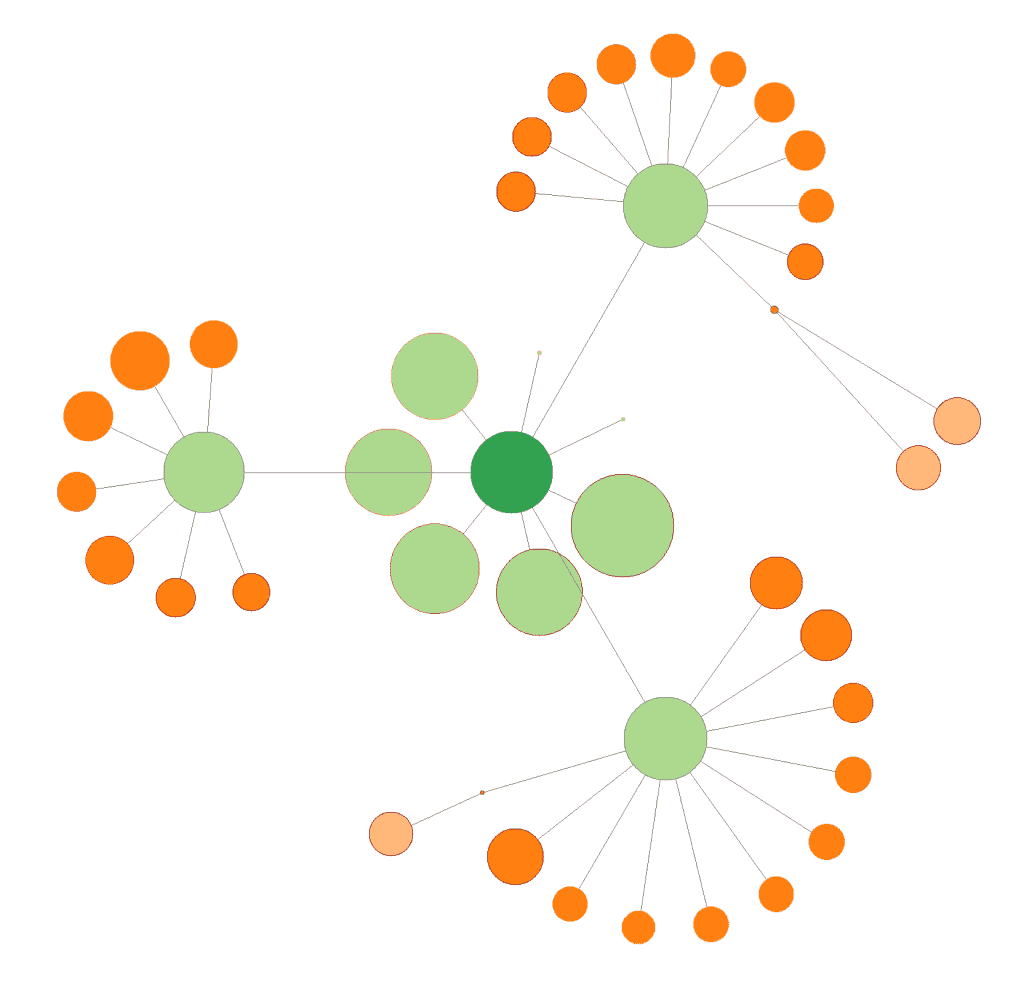
- On voit nettement les 3 catégories
- les différents articles ont tous un jus sensiblement équivalent
- On remarque la pagination qui a décalé respectivement 1 et 2 articles pour deux catégories.
Il n’y a pas photo, n’est-ce pas ?
On peut même faire encore mieux.
Si ce qu’on veut, ce n’est pas pousser les têtes de cocon, les catégories, on peut vouloir conserver du jus dans les articles, pour qu’ils aient plus de poids, et donc plus de punch pour ranker.
Voilà ce que ça donne avec une optimisation « poussée » :
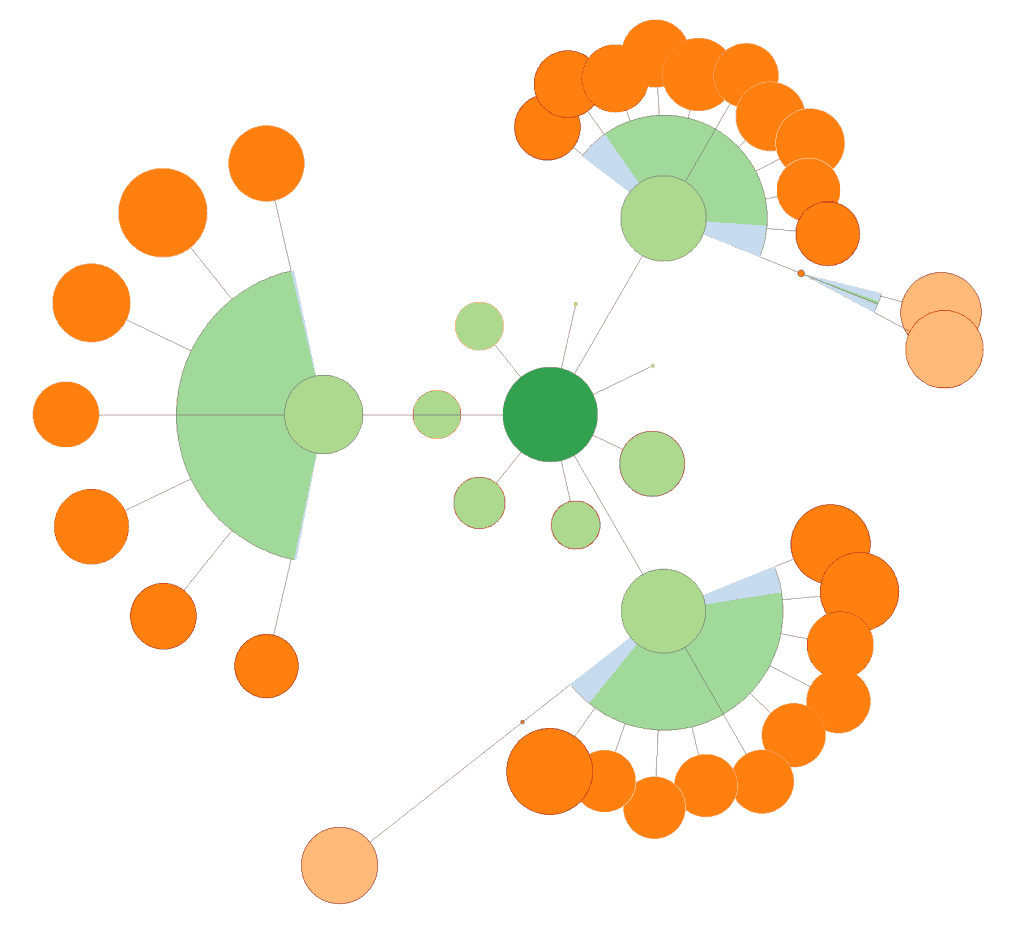
- Tous les articles ont du jus
- Les catégories aussi, mais pas trop
- Les autres pages (contact, mentions légales) ne prennent pas une importance démesurée
- Les silos sont parfaitement isolés (la petite proportion de bleu qu’on voit dans les éventails est due à la pagination, et ça se règle du point de vue Google avec les rel=next, rel=previous
En conclusion
- Un WordPress, de base, est tout sauf optimisé.
- En mettant un peu les mains dans la cambouis, on peut en faire ce qu’on veut
- Une visu « qui va bien » permet de s’assurer que le crawler voit ce qu’on veut lui montrer, et pas un plat de spaghettis.
Intéressante comme analyse, mais pouvez vous en dire plus sur le genre d’optimisation que vous avez fait pour en arriver au dernier graphe (par exemple) ?
Bonjour Luc,
C’était le sujet de notre conf du VLC, et de celle de Daniel Roch qui a suivi.
J’en dirai plus au fur et à mesure des articles.
En gros, c’est surtout un travail sur les liens par défaut de WordPress.
Suppression des choses inutiles, parasites, site-wide, renforcement des liens « utiles ».
Le tout en vérifiant étape par étape que ça va bien dans le bon sens. Avec la circulation du PR, on a parfois des surprises !
Bonjour,
le sujet me passionne alors forcément votre article aussi. Il est vrai que j’aurai tendance à me focaliser sur les pages et non les articles pour mettre en place un cocon sémantique comme on dit.
Je n’ai pas pu assister au VLC. Mais si Daniel Roch allait dans votre sens, alors je suppose qu’on retrouve ces infos dans son livre. (lu les deux premières versions). j’attends avec impatiences vos prochains articles.
Un sujet qui m’interpelle est celui des tag, étiquette pardon. On peut imaginer aisément qu’elles sont un frein. Mais bien pensées, sans concurrence avec les catégories, elles peuvent permettre de ranker je pense, du coup… vivement vos prochains articles.
PS : un exemple d’utilisation d’étiquette. Je suis le site du comité de volley d’Ille et Vilaine, j’ai des pages de résultats et classements, mais aussi des articles où je relate les évenements, et dans ces évenements je vais mettre en étiquette le nom des clubs concernés. je n’aurai jamais de catégorie concurrente. Et je finis par avoir une belle page consacrée à chaque club. Utile au visiteur, et bien positionnée sur GG.
Désolé si j’ai dévié du sujet… c’est le commentaire de Luc et votre réponse qui m’ont poussé vers là 😉
Hello Régis,
Merci pour le commentaire étoffé et pertinent.
Effectivement, il est peut être plus « facile » d’utiliser des pages et leur structure hiérarchique pour faire un cocon. Je montrerai d’ailleurs prochainement un exemple dans ce sens.
Je voulais justement montrer ici, que même avec des catégories et articles, on pouvait le faire, sans forcément tout casser.
En pratique (et je vais essayer de faire ça sur ce site ci), je joue sur sur deux tableaux, pages et articles. Les pages pour tout ce qui reste « stable » dans le temps, les articles pour les exemples, détails, précisions. L’un comme l’autre, en cocon.
En ce qui concerne les tags, je pense qu’on est d’accord sur le fond.
Par défaut, mal utilisé, ça n’a pas de sens.
Dans des cas précis, avec une réflexion en amont sur le choix et la raison d’utiliser les tags, ça peut être un classement tout à fait pertinent, et transversal par rapport aux catégories.
Sylvain Richard en a parlé dans un article:, sur son blog par exemple, il utilise les tags pour le niveau « débutant », »Intermédiaire », »avancé » de ses articles.
Même chose pour votre club de volley.
L’effet de bord à surveiller/mesurer, c’est que les clubs qui participent à plus d’évènements auront plus de liens internes, et on peut donc introduire une boucle de rétroaction qui va favoriser les gros évènements et les gros clubs (et ça peut être voulu, mais pas toujours).
Ça mériterait une étude de cas sur un site ad-hoc, pour voir précisément quel effet peut avoir une utilisation chirurgicale de tags sur la circulation du jus.
En effet, un article intriguant et intéressant pour tout SEO qui cherche à approfondir ses techniques de linking interne. Mais là, clairement, on veut en savoir plus (sur l’outil de visualisation, sur les optimisations faites dans l’exemple…) ! 🙂
J’ai le livre de Daniel Roch sur l’optimisation de WordPress pour le SEO, je suppose qu’un certain nombre de vos optimisations son présentent dans ce livre, je me trompe ?
Oui, certaines optimisations sont « universelles ».
Ici, on met surtout l’accent sur le contrôle : L’idée, c’est qu’il n’y a pas forcément UNE optimisation unique et qui va bien pour tout le monde.
Il y a également une incidence forte du Thème choisi, de ce qu’on met en sidebar, du menu ! …
On peut faire des choix « à priori », mais la réalité n’est pas toujours cohérente.
Avec la visu « crawler » qu’on développe, on voit le site comme Google le voit, on peut donc vérifier (ou infirmer) le fait que notre structure est conforme à ce qu’on a prévu, que le jus circule et s’accumule sur les pages que l’on souhaite les plus fortes par exemple.
D’autres visus, interactives celles là, permettent d’entrer plus avant encore dans le détail, on y viendra dans les articles suivants.
Bonjour filou(sophie de la g-raph),
Une mesure complémentaire qui ferait sens ici est la valeur globale du jus du site grâce au modeling, car, 25% de x est moins bien que 15% de 2*x 😉
Pour le reste, en modélisant un site parfait et en le passant dans les tuyaux, on peut, via du delta-modeling, deviner ce qu’il faut modifier sur un site…
Merci pour votre conf à tous les 2, elle était super.
Merci Christian,
En effet, il y a quelques métrics que l’on peut/doit ajouter.
Dans notre approche « site supposé isolé » (on est d’accord que c’est une approximation), le PR total est proportionnel au nombre de pages;
D’ailleurs, sur un site de 10 pages, on peut faire le linking qu’on veut, ça n’aura que peu d’incidence.
C’est quand on monte en volume qu’on a un effet « pr » qui commence à se faire sentir.
Dans les deux cas, ça met tout de même en évidence la circulation et l’accumulation du jus.
Si j’ai une page (autre que la home par exemple) qui accapare tous le jus, c’est aussi là que va se concentrer le jus en provenance des liens externes vers la home.
D’autres métrics, comme la répartition du PR selon le niveau depuis le départ, le nombre de pages par niveau… sont aussi intéressantes d’un point de vue global.
Le « défi » pour cette visu, c’était : peut-on avoir une visu « simple » qui rende compte d’un seul coup d’oeil de la présence ou non de cocons, de leur isolation, de difficultés éventuelles au crawl/indexation.
De ce point de vue, je pense que c’est gagné, et c’est un bon début 🙂
Que c’est joli ces graphes. T’as vraiment eu l’idée de l’année en voulant de débarrasser de Gephi.
Par rapport à ta remarque sur la possibilité d’améliorer un WP sans passer par les pages, c’est certes possible dans une certaine mesure. Dès que le volume de contenu augmente, le classement chronologique revient te mordre obligatoirement.
Merci Laurent,
En fait, c’est pas pour virer Gephi, qui rend bien des services ; c’est plus par frustration de ne pas pouvoir faire ce que je voulais avec (manque de certaines fonctions, et surtout plantage/besoin de RAM pour des gros sites).
Et puis, Gephi ne connait pas les cocons, alors là… c’était plié !
D’accord en grosse partie sur le volume. Dès qu’on a des paginations, ça complique tout.
On peut toutefois jouer avec les rel=next pour « condenser » les pages aux yeux de Google, et/ou augmenter le nombre d’articles par page, ou encore trier par autre chose que la date…
Sur ce site, je vais essayer de faire mixte: cocons sur les catégories, et sur les pages (selon le type de contenu).
Plus que ça, t’as aussi le glissement qui part souvent en couilles quand c’est chronologique.
J’ai observé ce phénomène quand j’ai traité des sites d’éditeurs de contenu massif.
On est d’accord, le blogging généraliste ne s’accorde pas avec le cocon.
Il faut le mindmap et l’organisation, la structuration en amont, puis une segmentation, quel que soit le moyen technique de publication qui va avec.
Si c’est massif, c’est problématique dans tous les cas. Même si tu vas ranger dans la bonne page le bon contenu au bon endroit, bien profond, il faut tout de même ‘alerter’ les visiteurs d’un nouveau contenu, donc l’aspect chrono ne peut pas être totalement mis de coté.
Bref; tu as plus d’expérience que moi sur ces sujets 😉
Sympathique étude. Question : connaitriez-vous un plugin qui permet justement de faire des règles de contenus relatifs selon le type de post mais aussi selon la catégorie ? Je n’ai pas encore trouvé ça dans WordPress 😉
Je n’en n’ai pas spécialement cherché, parce que je préfère en général faire à la main si c’est critique, ou sinon je laisse faire un « related » quelconque, avec le gros risque de fuite qu’on constate.
Appel aux lecteurs, s’il y a un plugin « related posts » pertinent et étanche, faites signe !
Pour arriver à ce que vous avez fait, ça a été plutôt du dév personnalisé pour regrouper les liens vers les contenus relatifs ou alors vous y êtes allés avec une solution existante ?
On parle bien de l’opti du site wp de base, qui se termine par des cocons bien étanches ?
Dans ce cas, on suppose que les articles d’une même catégorie sont « related », et le job consiste à éviter les liens d’une catégorie vers une autre (ce que WP fait à tout va). Une cat = un cocon, avec tous les articles qui sont des pages « soeurs ».
On peut aller plus loin en ne liant pas systématiquement toutes les pages soeurs, mais juste les « plus proches ».
C’est un peu pinailler: il y a déjà tellement de leviers sur lesquels jouer avant, ça se garde pour la fin, quand toutes les bases sont parfaites.
(ou alors, pour des raisons de conversion ou d’UX, et là c’est ça qui prend le dessus sur l’opti purement technique)
Merci pour ton retour :).
C’est ce genre de chose que je cherche à faire de façon permanente depuis les sites WordPress que je gère mais je voulais juste savoir si tu avais un plugin à me conseiller vraiment bien fichu sous WP qui permette de faire ça à peu près proprement.
Car comme tu le dis, la plupart des plugins permettent de n’afficher uniquement les articles d’une même catégorie mais ça va être seulement les derniers ou alors toujours la même batch, ce qui fait que les liens relatifs entre les contenus soeur d’une même catégorie ne sont pas super bien faits.
Très intéressant, vraiment hâte de pouvoir utiliser cet outil ! Une date de sortie en prévision ou pas du tout ?
Merci !
Ca dépend de l’intérêt qu’on perçoit, et de l’adéquation aux besoins des testeurs, des retours sur les visus et études de cas qu’on va montrer au fur et à mesure.
Pour les visus telles qu’on les a aujourd’hui, le code est ok, donc ça peut être rapide; mais on n’a rien décidé encore.
Bonjour,
Cet article est très intéressant et surtout très alléchant, j’ai hâte d’en lire la suite.
Concernant les articles relatifs, je ne garantis pas que ce plugin répondra à 100% à vos attentes, mais il faut savoir que WordPress Related Posts permet de choisir sur chaque article quels articles doivent être proposés en contenu relatif, si on prend la peine de ne pas se contenter du réglage par défaut qui se base sur la catégorie.
Cordialement,
Bruno
En plus de WordPress Related Posts, Daniel Roch, dans sa dernière conférence au VLC 2015 a également parlé de YARPP (Yet Another Related Posts Plugin) pour intégrer des articles relatifs basés sur un seuil de similarité basé qui se base sur le titre, le contenu, la catégorie, voir le tag et qui est modifiable. L’intérêt de ce plugin par rapport aux autres est de ne pas faire de lien si l’article est unique dans sa thématique. Bien sûr il est gratuit, avec plus d’options en payant.
Merci Benjamin 😉
Bonjour,
Merci à Laurent d’avoir fait suivre l’info vers votre site et votre futur outil. Je trouve vraiment l’idée très intéressante. Si vous avez besoin de bêta-testeur, je suis client !
Régis – http://www.blackchili.fr
Bonjour,
C’est joli, vous décrivez ce que vous faîtes et ce que vous obtenez mais, est-ce bien ce que l’on recherche ?
1. pour utiliser la sérendipité chez nos lecteurs ?
2. quels résultats sur les moteurs de recherche, et notamment Google ? (À mon avis, aucun, voire pire, mais je veux bien qu’on me démontre le contraire).
En effet, il convient de créer une hiérarchie claire,
En effet, il faut proposer un parcours par catégories à celles et ceux qui apprécient ce mode de travail,
Mais la volonté d’hyper structurer et « fermer » les liens n’a pas, à ma connaissance, fait ses preuves que ce soit en référencement naturel ou en performance d’un site quand un Internaute s’y rend.
Bien à vous,
Hal
Bonjour Hal, et merci pour le commentaire.
Je pense que ton commentaire est issu d’une lecture « hors contexte » de ce à quoi on travaille.
Lors de la conf VLC, j’ai insisté sur le fait que la dernière manip pour redonner le maximum de jus aux pages était extrême et pas forcément adaptée.
J’ai également insisté sur la dualité UX/ juice sculpting.
Je ne dis certainement pas qu’il faut tout isoler et tout structurer à fond.
Si on peut comprendre ça en me lisant, je me suis fort mal exprimé.
Il suffit de voir les différentes études de cas (ex, le cas LKS, où les fuites sont les bienvenues) et le travail en cours sur ce site pour avoir preuve du contraire.
Notre approche est la suivante :
– on part de ce qu’on veut obtenir
* les pages à pousser
* les pages moins utiles
* le type de maillage interne qu’on veut obtenir (silo ou pas, linking à la Laurent Bourrelly ou pas), selon les sections.
– on crawle le site, d’une part pour détecter les choses bloquantes pour un crawler, et ensuite pour avoir des datas exploitables
– la visualisation permet de voir, en un coup d’oeil, si ce qu’on a voulu, supposé de l’architecture interne, est cohérent ou pas.
C’est ainsi qu’on détecte une page « admin » qui absorbe tout le jus du site, des pages « inutiles » (mentions légales) qui ont plus de PR que des pages à contenu utile;
des silos que l’on veut isolés qui ne le sont pas du tout (ou inversement…) ; des pages censées pousser leur parente qui ne le font pas.
Il n’y a certainement pas UNE structure de site unique et parfaite qui colle à tout le monde.
Il ne faut certainement pas pénaliser l’UX juste pour isoler sans raison des pages, etc.
Ce que permet l’outil, c’est d’avoir une structure et une circulation de jus qui correspond à ce que l’on veut. Point.
Si on ne sait pas ce que l’on veut ni pourquoi, on est mal barré, aucun outil n’y fera rien.
Ensuite, quant à la corrélation avec l’effet sur les serps, c’est l’expérience et les études de cas qui parle et parleront.
Le maillage interne A, c’est évident, une incidence forte sur les rankings. Notre outil permet de présenter ce maillage sous une forme lisible.
On ne lui en demande pas plus 🙂
Un élément que j’ai du mal à comprendre est la proportion de vert dans les éventails.
A quoi correspond-elle réellement ? A des liens ? A la puissance que la catégorie donne aux articles ?
Pour comprendre, il faut avoir en tête le linking « cocon » à la mode Laurent Bourrelly.
Je ferais un article détaillé sur ce que représente cet éventail.
Il représente l’isolation du cocon qui suit l’éventail, en fonction des liens sortants des pages du cocon.
plus il y a de bleu, et plus il y de liens vers d’autres cocons.
plus il y a de vert, plus il y a de liens entre soeurs.
Les liens vers les filles, ainsi que les liens qui « retournent » un ou plusieurs niveaux plus haut dans la même branche ne sont pas comptabilisés dans ces proportions.
OK, c’est plus clair, merci 🙂